


Przemysław Janicki, Sr Pre-Sales Solutions Architect, Risk Solutions GSZ/CE, SAS
Obliczenia kwantowe (ang. quantum computing) to szybko rozwijająca się dziedzina badań stosowanych o potencjalnie dużej zdolności rozwiązywania złożonych problemów i wykonywania obliczeń bądź to wykraczających poza granice możliwości klasycznych komputerów, jakie towarzyszą nam od dziesięcioleci, przetwarzających porcje informacji w sposób deterministyczny (dodając dwa do dwóch tysiące razy zawsze otrzymamy cztery) przy użyciu tranzystorów i bramek logicznych, bądź też – z powodów, o których za chwilę – nigdy dla nich nieosiągalnych.
Komputery kwantowe do przetwarzania informacji wykorzystują osiągnięcia mechaniki kwantowej. Jest to dziedzina fizyki o fundamentalnym wręcz dziś znaczeniu, która wyjaśnia zachowanie oraz oddziaływania materii i energii w najmniejszych skalach, takich jak atomy i cząstki subatomowe, choć jej początki sięgają pierwszych dekad XX wieku i osiągnięć takich pionierów teorii kwantowej jak Max Planck, Albert Einstein, Niels Bohr czy Erwin Schrödinger, które to osiągnięcia – głównie w domenie teoretycznej i eksperymentalnej – kilkadziesiąt lat później (od mniej więcej lat 80. XX wieku) zostały przestawione na tory praktycznych zastosowań w dziedzinie obliczeniowej przez fizyków w rodzaju Richarda Feynmana czy Davida Deutscha (współautora pierwszego algorytmu kwantowego po raz pierwszy opublikowanego w 1992 r.), do których niebawem dołączyli matematycy i informatycy tacy jak Peter Shor (autor słynnego algorytmu faktoryzacji, czyli rozkładu liczby na czynniki pierwsze, 1994), Aleksiej Kitajew (który zaproponował algorytm szybkiej kwantowej transformacji Fouriera, 1995) czy Lov Grover (kwantowy algorytm przeszukiwania baz danych, 1995).
Dlaczego komputery kwantowe są potrzebne
Richard Feynman, uznawany za jednego z największych fizyków naszych czasów, w jednym ze swoich wykładów wygłoszonych w California Institute of Technology (Caltech) w Pasadenie („Simulating Physics with Computers”, ogłoszonego w formie artykułu), półtorej dekady po przyznaniu mu w 1965 r. Nagrody Nobla za niezależne stworzenie relatywistycznej elektrodynamiki kwantowej, zadał pytanie: „Czy układ kwantowy może być probabilistycznie symulowany przez klasyczny (nawet gdyby był probabilistyczny) komputer uniwersalny?”. Innymi słowy, czy coś z natury kwantowego może być symulowane przez komputer, który nie jest kwantowy? Już w kolejnym zdaniu dał odpowiedź: „Jeżeli przyjmiemy, że komputer jest komputerem klasycznym (…), że żadne prawa nie ulegają zmianie i nie wchodzi w grę żadne hokus-pokus, odpowiedź z pewnością brzmi: nie!”.
Przyczyny tak kategorycznej odpowiedzi zostały przez Feynmana – wybitnego naukowca i świetnego dydaktyka zarazem, hołdującego własnej wersji brzytwy Ockhama, zwanej techniką Feynmana: jeżeli potrafisz coś wytłumaczyć w prosty sposób, to znaczy, że naprawdę to rozumiesz – natychmiast wyjaśnione: mamy do czynienia z problemem ukrytych zmiennych (ang. the hidden-variable problem), który sprawia, że nie da się przedstawić wyników mechaniki kwantowej za pomocą klasycznego komputera uniwersalnego. Uzasadnienie tej tezy znajdziemy w piątej części przywołanego artykułu Richarda Feynmana, a sprowadza się ono, z grubsza rzecz biorąc, do ukazania swoistej odmienności świata i towarzyszących mu zjawisk na poziomie kwantowym, gdzie istnieją „immanentne indeterminizmy” wynikające głównie ze słynnej zasady nieoznaczoności Wernera Heisenberga. Można też powiedzieć (w duchu Feynmana upraszczania tego, co skomplikowane), że stan układu fizycznego nie daje jego pełnego opisu, co w zasadzie automatycznie wyklucza z pewnych zastosowań klasyczne komputery deterministyczne, niezależnie od ich mocy.
Kwantowa dominacja
Wszystko to nie musi jednak prowadzić do wniosku, że komputery kwantowe będą musiały zastąpić komputery oparte na klasycznej architekturze, gdyż w przypadku wielu codziennych zadań, takich jak przeglądanie zasobów internetu, przetwarzania tekstu czy obróbki filmów, standardowe komputery wciąż mogą się okazać wystarczająco wydajne, a na pewno znacznie mniej… kosztowne. Autorzy pierwszych algorytmów kwantowych uświadomili nam po prostu, że komputery kwantowe teoretycznie mogą przewyższać komputery klasyczne w niektórych zadaniach, sam zaś Richard Feynman uświadomił nam wiele lat wcześniej, że niektórych zagadnień o potencjalnie doniosłym znaczeniu dla całej ludzkości po prostu nie będziemy w stanie rozwiązać bez wsparcia ze strony komputerów kwantowych.
Do pierwszej grupy możemy zaliczyć różnego rodzaju zagadnienia symulacyjne i optymalizacyjne (choćby bardzo praktyczne i „przyziemne” zagadnienie wyceny instrumentów finansowych czy optymalizacji składu portfela inwestycyjnego), ale też, wspomniane już, algorytmy faktoryzacji, które mają bezpośrednie przełożenie na nasze bezpieczeństwo z uwagi na to, jak działa współczesna kryptografia. W ogólnym zarysie proces rozkładu dowolnie dużej liczby na czynniki pierwsze stanowi na tyle trudne wyzwanie dla komputerów klasycznych, że od dziesięcioleci stanowi punkt wyjścia w popularnych protokołach bezpieczeństwa takich jak TLS czy RSA, a także technologii łańcucha bloków (ang. blockchain) i opartych na niej rozwiązań, jak kryptowaluty w rodzaju bitcoina. TLS i RSA chronią przed nieupoważnionym dostępem znaczną część codziennego ruchu w internecie, a technologia blockchain oferuje integralność i bezpieczeństwo przechowywanych danych, m.in. zapewniając nienaruszalność i transparentność historii transakcji kryptowalutami (i nie tylko nimi).
Do drugiej grupy problemów moglibyśmy zaliczyć te, które mają naturę kwantową, co w świetle przytoczonego wykładu Richarda Feynmana powoduje, że klasyczne komputery nigdy nie pozwolą nam ich rozwiązać. Według aktualnego stanu wiedzy moglibyśmy zaliczyć tutaj poznanie natury tak fundamentalnych dla życia na Ziemi zjawisk jak fotosynteza, czy dalszy rozwój chemii obliczeniowej, który mógłby skutkować nie tylko obniżeniem kosztów wytwarzania i testowania nowych leków, ale docelowo mógłby doprowadzić do rozwoju medycyny w pełni spersonalizowanej, a więc odzwierciedlającej fizjologię indywidualnego pacjenta i jej specyfikę. Z pewnością przyczynią się też do wynalezienia nowych rewolucyjnych materiałów. W obszarze sztucznej inteligencji komputery kwantowe mogą pomóc w optymalizacji uczenia modeli, potencjalnie prowadząc do powstania bardziej inteligentnych i wydajnych systemów AI – już dziś generatywna sztuczna inteligencja potrafi wiele, dlatego możemy sobie wyobrazić, ile by mogła zdziałać, gdybyśmy dysponowali znacznie większą mocą obliczeniową, skracającą proces uczenia niektórych modeli językowych z tygodni czy miesięcy do interwału wyrażanego w sekundach. Również problemy takie jak modelowanie klimatu wymagają ogromnej mocy obliczeniowej ze względu na ogromną złożoność układów klimatycznych, więc i w tym zastosowaniu unikalne możliwości obliczeniowe komputerów kwantowych mogą umożliwić nam wydajną ich symulację, prowadząc nie tylko do dokładniejszych prognoz, ale i do głębszego zrozumienia zmian klimatu, których przecież doświadczamy.
Wnioski uzyskane z tych symulacji być może pozwolą nam odpowiedzieć ostatecznie na ciągle sporne, zdaniem wielu, pytanie, czy obserwowane zmiany klimatu mają charakter wyłącznie antropogeniczny, tym samym pomagając nam lepiej kształtować odpowiedzialną politykę i kreować bardziej zrównoważoną przyszłość. Te i inne wątki są rozważane w przystępny sposób m.in. przez H. Noaha w jego książce „21 lekcji na XXI wiek” (Wydawnictwo Literackie) czy w ujęciu nieco bardziej technicznym przez M. Kaku w książce „Kwantowa dominacja. Jak komputery kwantowe odmienią nasz świat” (wydawnictwo Prószyński Media). Ale nawet te stosunkowo nieliczne podane wyżej przykłady powinny nam uświadomić jak duże znaczenie może mieć dla każdego z nas kwantowa dominacja (ang. quantum supremacy), czyli moment, w którym przy pomocy komputerów kwantowych ostatecznie pokonamy bariery dalszego rozwoju komputerów klasycznych. I nie chodzi nawet o to, że już przy obecnym stanie technologii klasyczne komputery potrzebowałyby miliardów lat na rozwiązanie niejednego z problemów, który komputer kwantowy mógłby rozwiązać dosłownie w przeciągu chwili, ale o to, że powoli zbliżamy się do kresu technologicznych możliwości dalszej miniaturyzacji układów scalonych i idącej w ślad za nią zwiększania mocy obliczeniowej współczesnych komputerów.
Ograniczenia komputerów klasycznych
W ogólnym zarysie współczesne komputery oparte są na dużej liczbie tranzystorów, które możemy wyobrażać sobie jako pewien rodzaj przełącznika. Oznacza to, że tranzystor może znajdować się w jednym z dwóch stanów: włączonym (w zapisie cyfrowym reprezentowanym przez 1) lub wyłączonym (0). Ta informacja o stanie jest znana jako bit i jest najmniejszą jednostką informacji przetwarzanej przez komputer. Zadania jakie stawiamy przed naszymi komputerami są jednak dużo bardziej złożone i aby je zrealizować musimy połączyć wiele bitów, a zatem wykorzystać dużą liczbę tranzystorów. Im więcej bitów w komputerze, tym więcej informacji może on przetworzyć. Dlatego moc obliczeniowa klasycznych komputerów zależy przede wszystkim od technicznych możliwości upakowania miliardów tranzystorów na płytce drukowanej w postaci układów scalonych, a więc w praktyce od naszej zdolności do miniaturyzacji tranzystorów, która jednak ma swoje fizyczne granice. Znanym tego odzwierciedleniem jest obecny stan tzw. prawa Moore’a, które przewidywało systematyczne podwajanie liczby tranzystorów w układzie scalonym (a więc i mocy obliczeniowej komputerów) przy minimalnym nakładzie kosztów, ceteris paribus, a które – zdaniem coraz większej liczby ekspertów – na naszych oczach się dezaktualizuje.
Doświadczenia ostatnich lat mogą sugerować, że zbliżyliśmy się już do momentu, w którym przy obecnym stanie technologii dalszy istotny przyrost mocy obliczeniowej może znajdować się poza naszym zasięgiem. A jeżeli się odbędzie, to nie bez istotnego wzrostu nakładów – technologie produkcyjne nowej generacji, takie jak Extreme Ultraviolet Lithography (litografia w ekstremalnym ultrafiolecie, EUV), są bowiem drogie i wymagają wysoce specjalistycznego sprzętu, przez co producentom coraz trudniej jest osiągać korzyści skali, które wcześniej sprawiały, że prawo Moore’a tak dobrze się sprawdzało. Jak sugeruje pionier (klasycznej) techniki komputerowej Gene Amdahl w swoim wywodzie (nazwanym później prawem Amdahla), nie będziemy w stanie obejść tych ograniczeń przez szersze stosowanie układów wieloprocesorowych (wielowątkowych) i przetwarzania równoległego, gdyż wzrost szybkości wykonywania się klasycznego algorytmu komputerowego przy użyciu większej liczby procesorów w obliczeniach równoległych jest ograniczany nie tylko prawami fizyki, ale przez sekwencyjny podział algorytmu (i w efekcie jakiejś jego części nie da się zrównoleglić). Nawet jeżeli aż 95% kodu mogłoby być przetwarzane równolegle, wówczas maksymalny wzrost szybkości jego wykonania przy użyciu przetwarzania równoległego nie przekroczy 20-krotności poziomu odniesienia – i to bez względu na liczbę użytych procesorów (por. Rysunek 1).
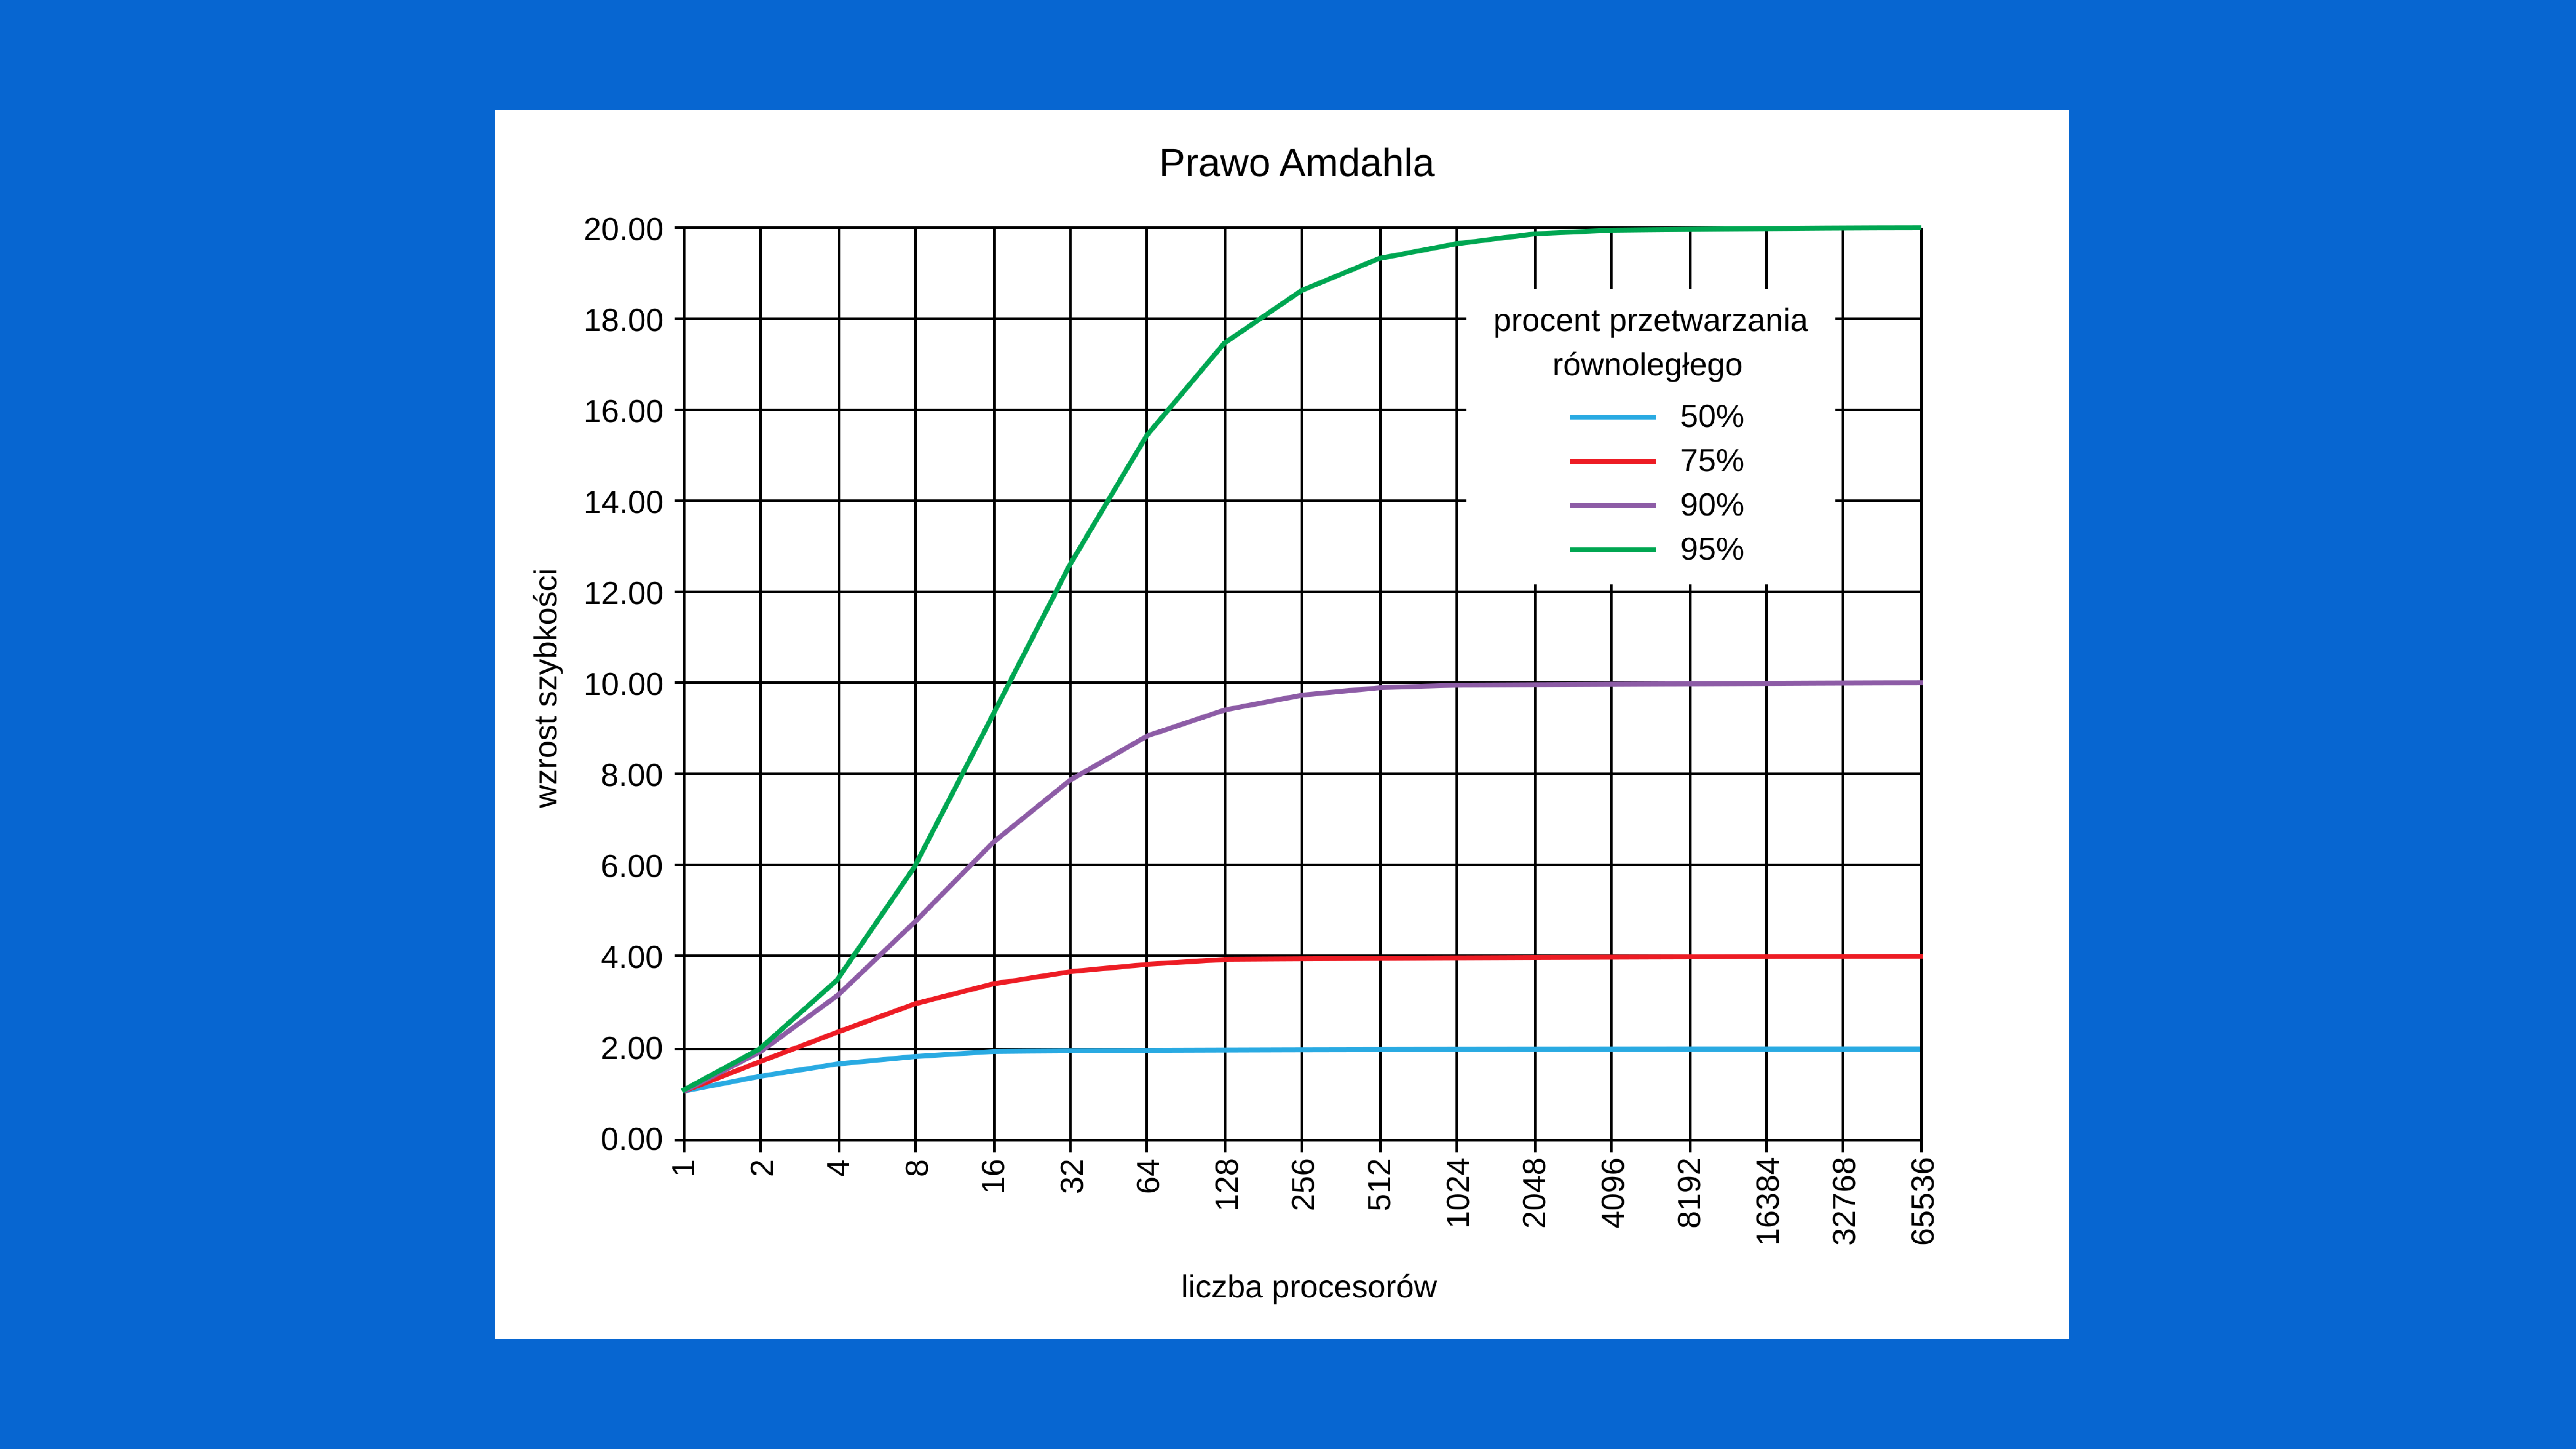
Rysunek 1. Wizualizacja prawa Amdahla (źródło: Wikipedia)
Natura obliczeń kwantowych
W przeciwieństwie do komputerów klasycznych, które operują na porcjach informacji zwanych bitami, komputery kwantowe wykorzystują tzw. bity kwantowe, czyli kubity (ang. qubits). Są one podobne jedynie z nazwy: kubity, dzięki wykorzystaniu takich zjawisk jak superpozycja czy splątanie kwantowe, pozwalają komputerom kwantowym wykonywać pewne obliczenia w sposób całkowicie odmienny, a przy tym znacznie szybciej niż najszybsze komputery klasyczne kiedykolwiek będą w stanie. Superpozycja pozwala kubitom reprezentować wiele stanów jednocześnie (a nie tylko logiczne stany 0 i 1 – przypomnij sobie znany eksperyment myślowy, a zarazem paradoks, kota Schrödingera), a splątanie tworzy szczególnego rodzaju stan skorelowania między kubitami (stan kubitu wpływa na stan kubitu z nim splątanego), co łącznie czyni komputery kwantowe tak wydajnymi w realizacji pewnego typu zadań (Albert Einstein był akurat tak sceptycznie nastawiony do idei splątania kwantowego, że nazwał je „upiornym działaniem na odległość”). Ale też powoduje, że algorytmy kwantowe i programowanie komputerów kwantowych różnią się fundamentalnie od swych klasycznych odpowiedników.
Kubity mają przy tym wady, a jedną z poważniejszych jest to, że w przeciwieństwie do klasycznych bitów są podatne na błędy przez swoją wrażliwość na warunki zewnętrzne. Nawet niewielka zmiana temperatury lub zakłócenia elektromagnetyczne mogą wpłynąć na stan kubitu, a korekcja błędów w komputerach kwantowych jest szczególnie trudna, ponieważ pomiar stanu kubitu może go zmienić (co więcej, fundamentalne dla mechaniki kwantowej twierdzenie o braku klonowania – ang. no-cloning theorem – stanowi, że nie da się wiernie skopiować informacji kwantowej). Obecnie opracowywane są różne techniki korekcji błędów, ale nadal pozostaje to jedną z największych barier w rozwoju obliczeń kwantowych, gdyż – jak zobaczymy za chwilę – korekcja może znacząco zwiększyć wymaganą liczbę kubitów ponad niezbędną do rozwiązania zagadnienia podstawowego (gdyby kubity nie były podatne na błędy). Wszystkie te aspekty sprawiają, że projektowanie algorytmów, które mogą efektywnie wykorzystywać takie zjawiska jak superpozycja czy splątanie kwantowe, wymaga odmiennego rodzaju myślenia i dobrego zrozumienia mechaniki kwantowej (a także m.in. algebry, liczb zespolonych czy rachunku prawdopodobieństwa). Dlatego jest to ciągle jeszcze umiejętność niszowa, na którą jednak popyt powinien tylko rosnąć.
Tworzenie i testowanie algorytmów z pewnością ułatwiają biblioteki i frameworki stanowiące rozszerzenie popularnych języków programowania, jak choćby IBM Qiskit, gdzie do tworzenia obwodów kwantowych (ang. quantum circuit) wykorzystujemy składnię języka Python (a same obwody mogą być uruchamiane na emulatorach lub rzeczywistych komputerach kwantowych). Rysunek 2 przedstawia wizualizację przykładowego obwodu stworzonego na potrzeby implementacji algorytmu Shora realizującego podział na dwa czynniki liczby 15, którego pełen opis znajdziemy na stronie: https://quantum.cloud.ibm.com/docs/en/tutorials/shors-algorithm
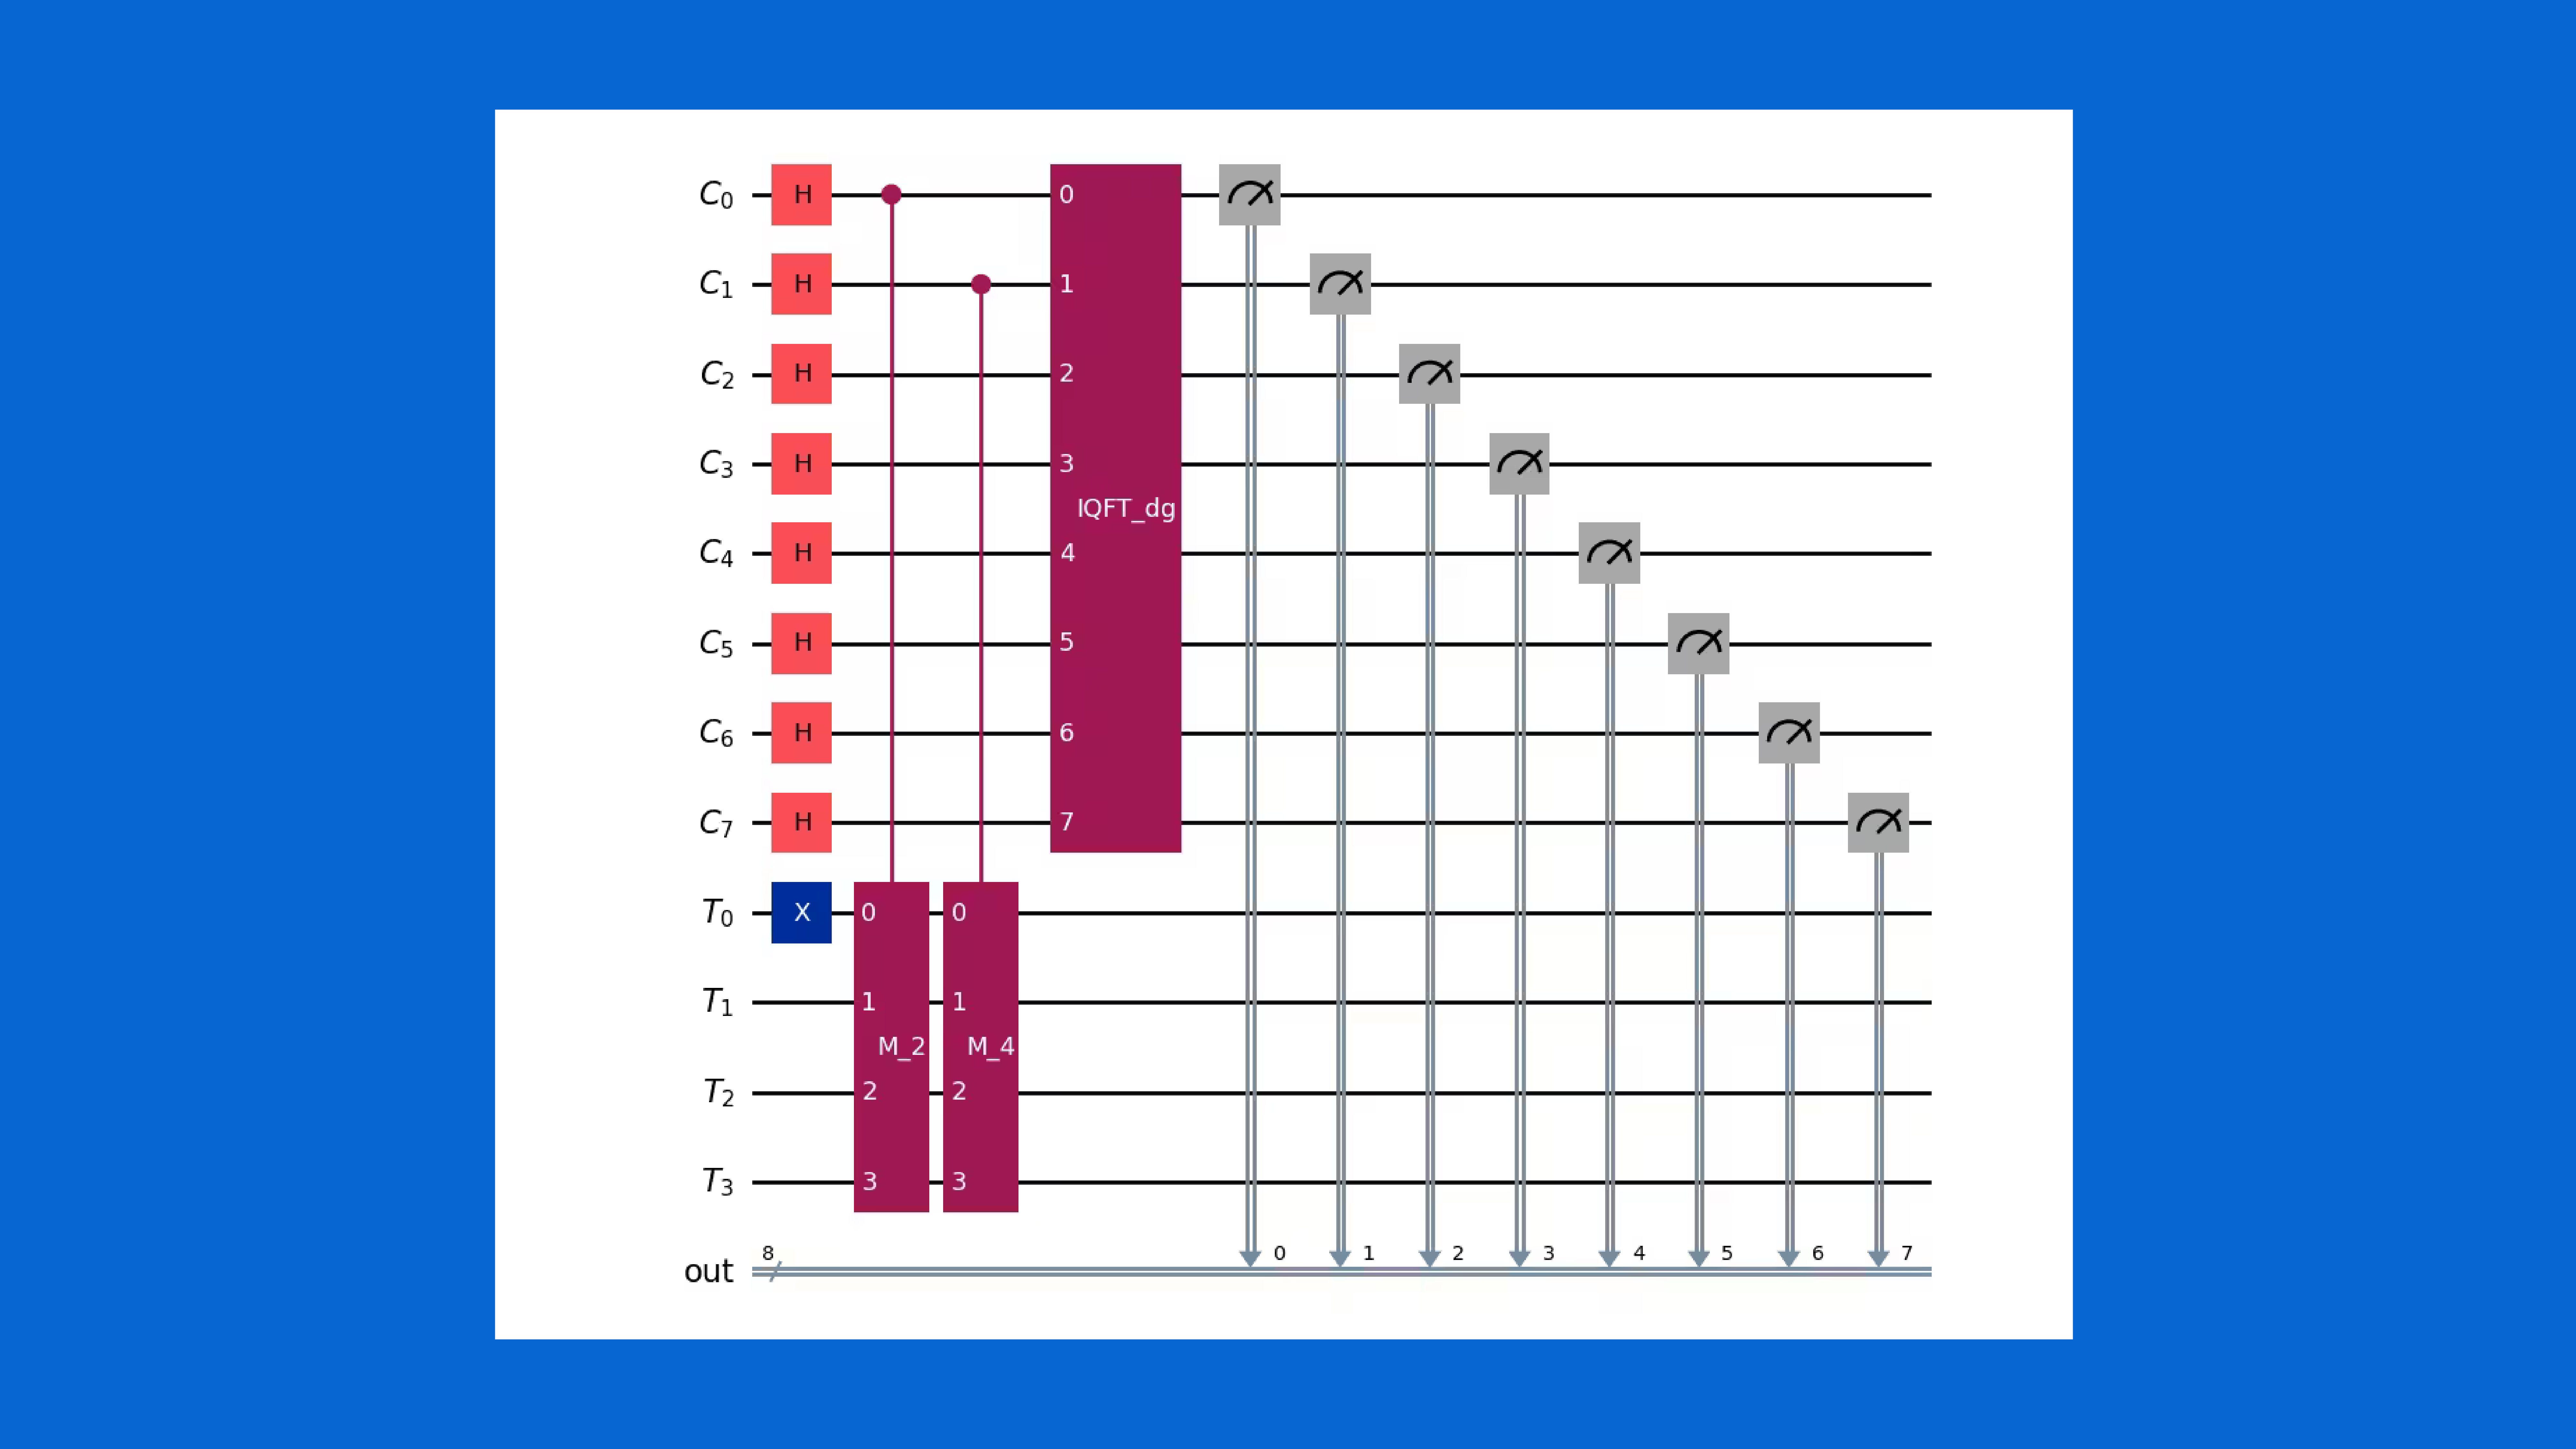
Rysunek 2. Przykładowy obwód kwantowy zaimplementowany przy użyciu frameworku IBM Qiskit (źródło: IBM)
Praktyczna implementacja algorytmu Shora przez IBM po raz pierwszy miała miejsce w 2001 r. na komputerze kwantowym typu NMR (ang. nuclear magnetic resonance) o 7 kubitach. Od tego czasu nastąpił znaczny postęp w fizycznej realizacji komputerów kwantowych. Jak jednak zauważa sam IBM w dającym do myślenia przykładzie, szyfrowanie RSA zazwyczaj wymaga już kluczy o długości rzędu 2048-4096 bitów. Próba rozłożenia liczby 2048-bitowej za pomocą algorytmu Shora na czynniki pierwsze wymusi powstanie obwodu kwantowego z milionami kubitów, wliczając w to narzut na korekcję błędów (gdyby nie ona, wystarczyłoby ich, jak się szacuje, 4000-6000). To przekracza realne możliwości obecnych komputerów kwantowych. Dlatego w celu praktycznego zastosowania algorytmu Shora do przełamania zabezpieczeń kryptograficznych będzie on wymagał zoptymalizowanych metod budowy obwodów lub znacznie wydajniejszej korekcji błędów. To nie tylko interesujące wyzwanie intelektualne, ale i zagadnienie o potencjalnie doniosłych skutkach dla świata jaki znamy i w jakim żyjemy.
Era NISQ
W zrozumieniu gdzie jesteśmy dzisiaj pomaga skala opracowana przez firmę Microsoft, znana jako Quantum Computing Implementation Levels. Wszystko wskazuje na to, że obecnie ciągle jeszcze znajdujemy się w tzw. erze Noisy Intermediate Scale Quantum (NISQ), czyli na stosunkowo wczesnym etapie rozwoju technologii kwantowych, kiedy to komputery kwantowe są wciąż stosunkowo małe i podatne na błędy, z drugiej jednak strony możemy być świadkami bardzo dynamicznego ich rozwoju (por. Rysunek 3). Nie zmieniają tego (jeszcze) pojawiające się niekiedy pogłoski – ze strony tej czy innej firmy budującej własnej komputery kwantowe – o osiągnięciu dominacji kwantowej.
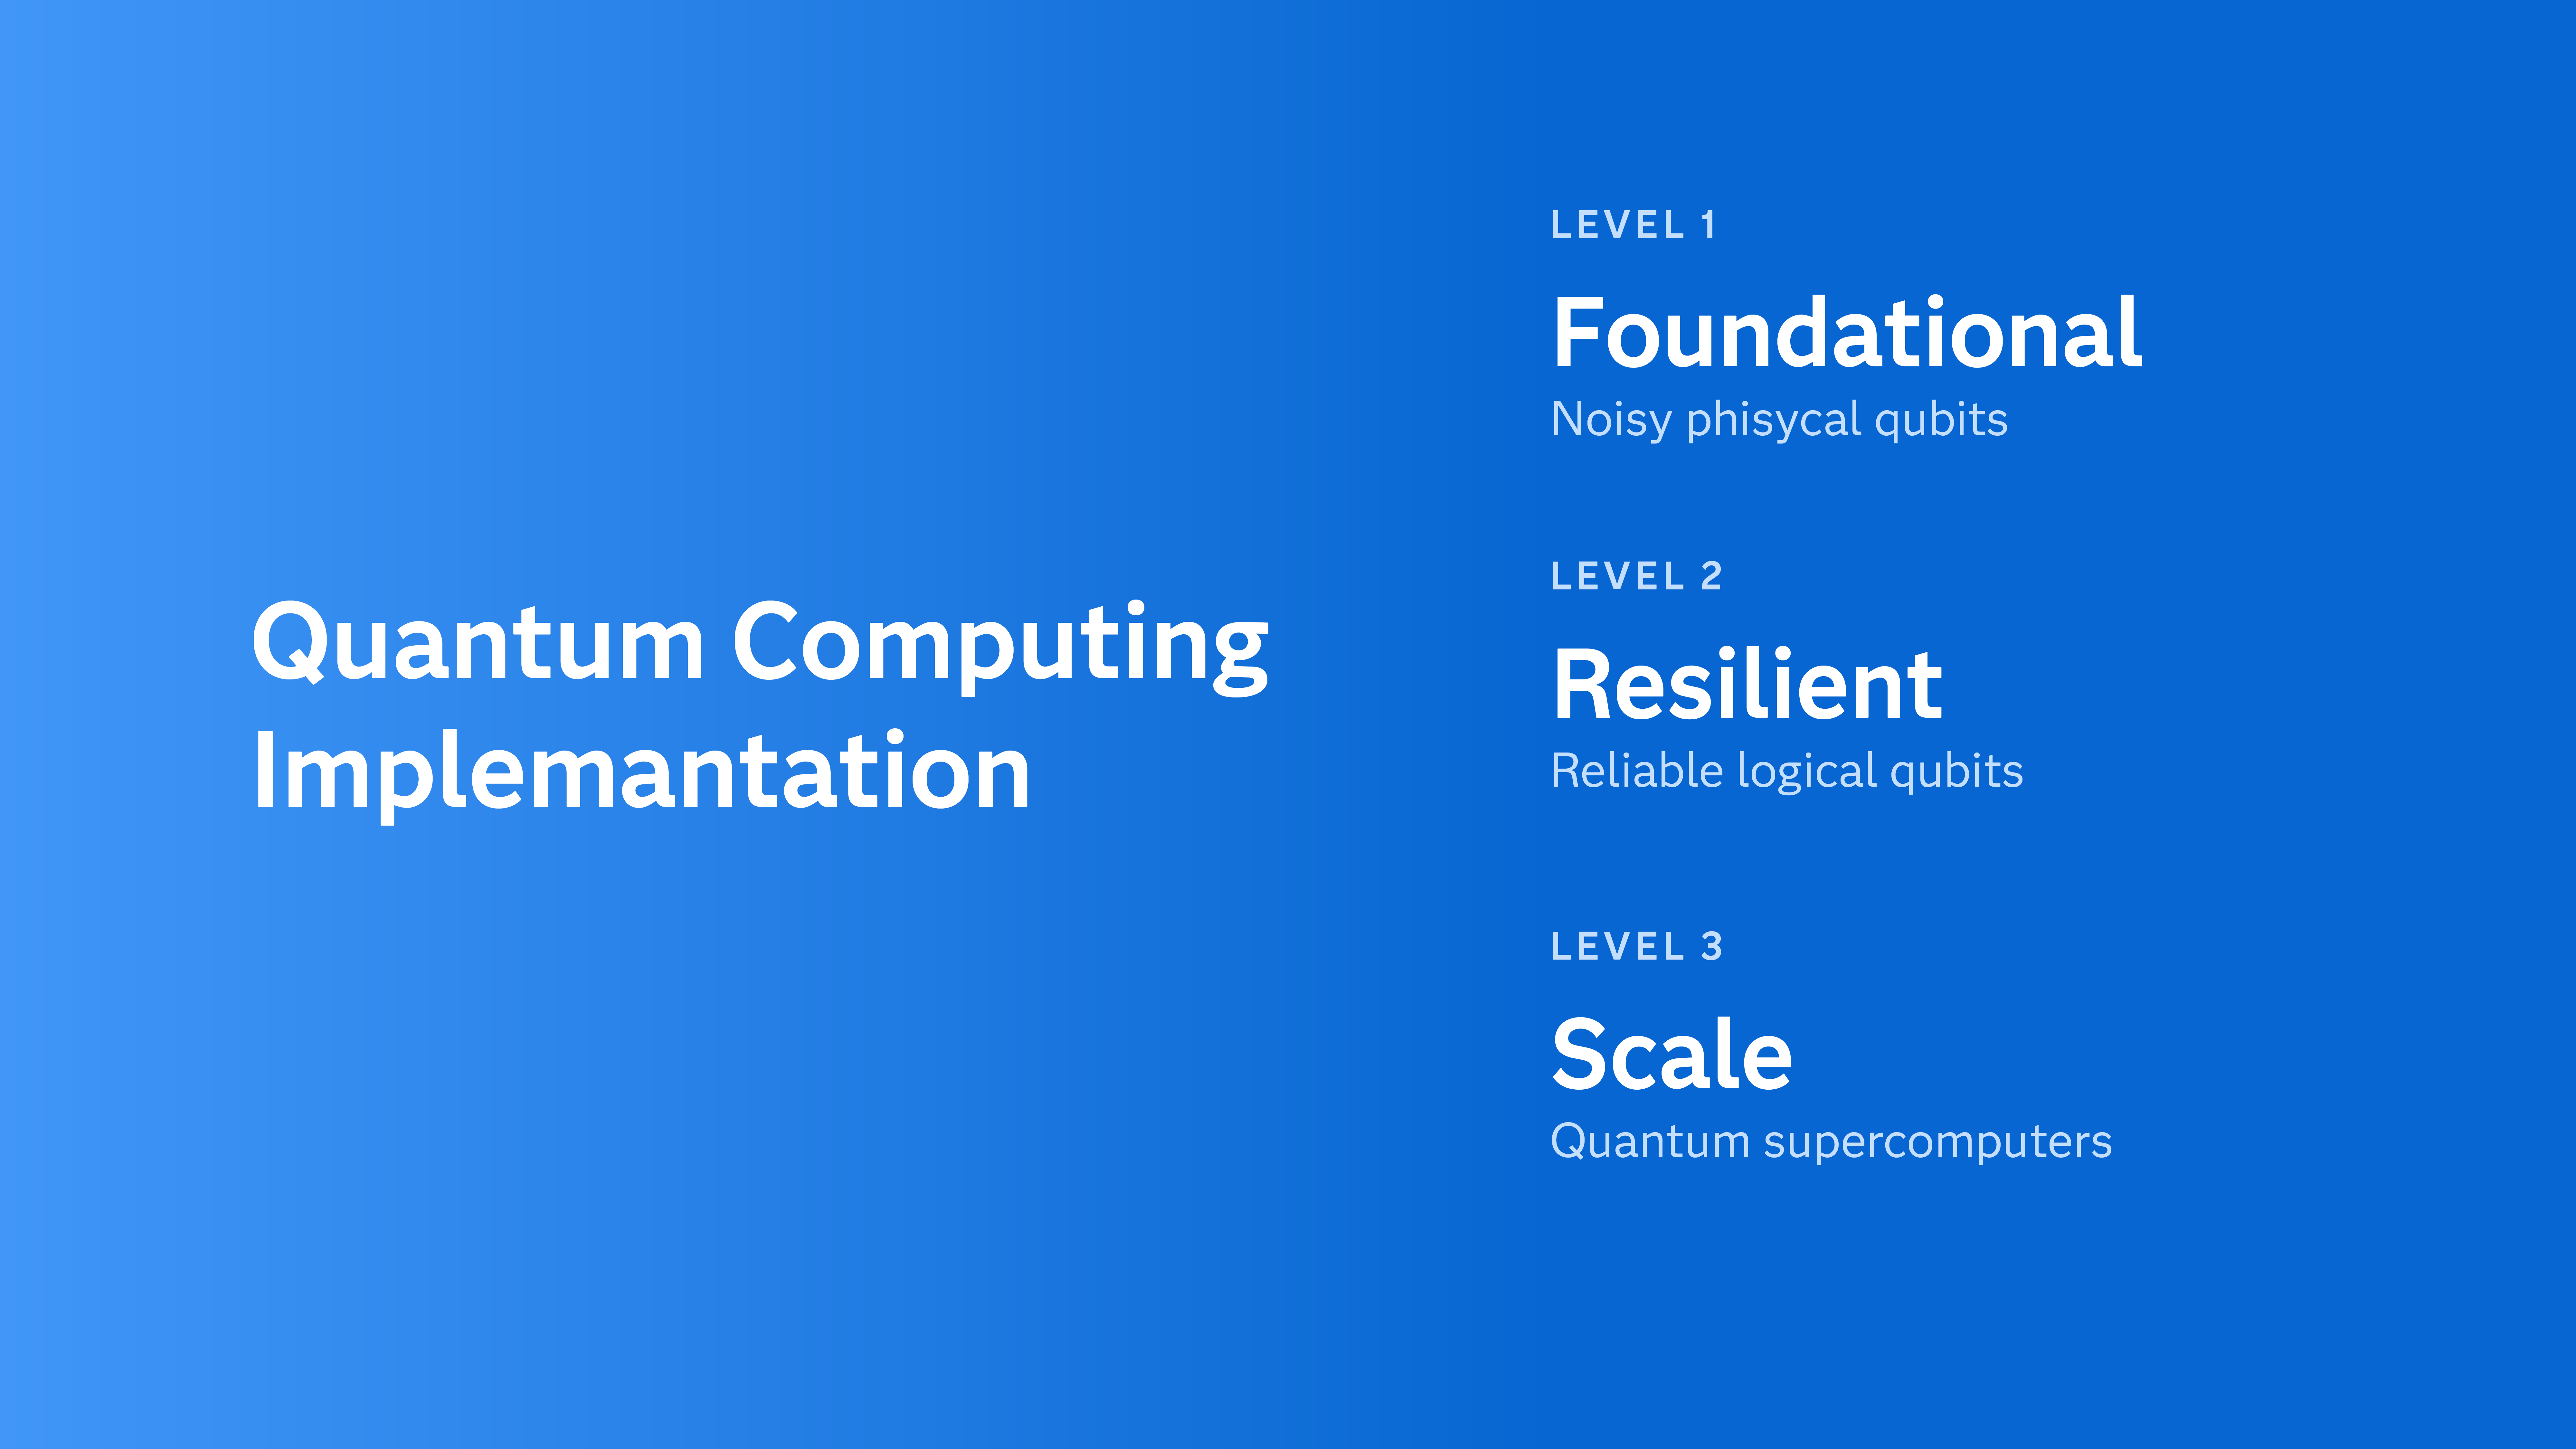
Rysunek 3. Trzy ery (poziomy) rozwoju komputerów kwantowych według Microsoft (źródło: Microsoft Quantum).
O ile komputery kwantowe są cały czas podatne na błędy, kwestia tego, na ile obecne komputery kwantowe możemy nazwać „stosunkowo małymi” może być w pewnym sensie dyskusyjna – nie da się bowiem postępu w rozwoju techniki oddzielić od postępów w rozwoju algorytmiki, które przecież następują również niezależnie od siebie. Jedyne co możemy dziś zrobić, to zweryfikować ją częściowo przez zestawienie topowych urządzeń istniejących dziś z szacunkami IBM na temat mocy (wyrażonej liczbą kubitów) niezbędnej do złamania algorytmu RSA. Według stanu na dziś do miana najbardziej precyzyjnego komputera kwantowego pretenduje Helios (stworzony przez Quantinuum, w której to spółce udziały nabyła Nvidia czy bank inwestycyjny JPMorgan Chase), największą liczbą kubitów może się poszczycić urządzenie stworzone w Caltech (tym samym, w którym pracował Richard Feynman), złożone z sieci 6100 kubitów, zaś w niektórych zadaniach najwydajniejszy okazuje się być chiński komputer oparty na nadprzewodzącym chipie Zuchongzhi-3. Najbliższa przyszłość pokaże, jak szybko będziemy mogli dowieść, że przeszliśmy do kolejnej ery w implementacji tej wiele obiecującej technologii. Warto przy tym pamiętać, że już dziś (w erze NISQ) pojawiają się opinie, iż przed 2030 r. złamanie 2048-bitowego klucza RSA będzie możliwe. W tym wyścigu każdy z nas może wziąć udział jako twórca ulepszonych algorytmów.
Przemysław Janicki, Sr Pre-Sales Solutions Architect, Risk Solutions GSZ/CE, SAS
Przystępując do codziennej pracy analityka danych czy twórcy modeli zwykle nie zastanawiamy się nad naturą naszych danych. W dotychczasowej praktyce były one bowiem niemal zawsze wytworem otaczającej nas rzeczywistości, stanowiąc jej ilościowy lub jakościowy opis w czasie lub przestrzeni. Dane telekomunikacyjne, finansowe, odnoszące się do zdrowia populacji czy zwyczajów zakupowych konsumentów – wszystkie łączy jedno: są to dane, które stanowią rezultat rzeczywistych zjawisk czy procesów mających miejsce w określonym momencie w przeszłości.
Dlaczego dane rzeczywiste nie zawsze wystarczają?
W niektórych dziedzinach zastosowań wykorzystanie danych rzeczywistych nie zawsze jest jednak możliwe lub racjonalne – choćby z powodu kosztów związanych z ich pozyskaniem. W innych przypadkach, choć dane takie będą co do zasady stanowiły podstawę naszej pracy, ograniczanie się do ich analizy w postaci „as is” nie zawsze będzie rozwiązaniem optymalnym – tu za przykład może nam posłużyć jakże częsty przypadek niezbilansowanej próby, gdy wybrane jej segmenty (grupy, warstwy) okazują się niedoreprezentowane (nadreprezentowane), prowadząc do istotnego obciążenia (bias) wskazań modelu – lub też sytuacja gdy nasza próba jest zbyt mało liczna, by w oparciu o nią móc przeprowadzić racjonalne wnioskowanie (albo też będzie wykazywała zbyt małą wewnętrzną zmienność, odzwierciedlając tylko niewielką część możliwych kombinacji stanów wektora wejściowego dla modelowanego zjawiska).
W jeszcze innych sytuacjach oparcie wnioskowania na danych rzeczywistych nie będzie w ogóle możliwe, ponieważ dane takie po prostu nie będą istnieć. Mamy tu na myśli wszelkiego rodzaju analizy symulacyjne lub scenariuszowe, które często towarzyszą wprowadzaniu na rynek nowego produktu czy usługi, weryfikowaniu skuteczności nowatorskiej terapii (medycznej) czy choćby ocenie skutków regulacji. W tych i innych przypadkach przychodzą nam z pomocą dane syntetyczne (por. rysunek 1).

Rysunek 1. Przykładowe obszary i sposoby wykorzystania danych syntetycznych.
Jak dane syntetyczne uzupełniają rzeczywistość?
Dane syntetyczne to klasa danych, które są generowane sztucznie. W przeciwieństwie do danych rzeczywistych, które zostały bezpośrednio zaobserwowane i zarejestrowane, dane syntetyczne zostały celowo i w uporządkowany sposób wytworzone. Kluczem do zrozumienia sensu ich wykorzystania jest właśnie owa celowość. Nie należy bowiem mylić danych syntetycznych z danymi przypadkowymi – przeciwnie, generując dane syntetyczne dążymy do tego, by w jak największym stopniu oddawały one charakterystyki rozkładu (lub inne cechy) danych, które wzbogacają lub zastępują. Tworzymy syntezę danych rzeczywistych i na tej podstawie generujemy nowe, nierejestrowane w przeszłości, dane – w szczególności generując je dla warunków, których (jeszcze) nie zaobserwowano. Choć więc dane rzeczywiste będą prawie zawsze najlepszą podstawą wnioskowania (z zastrzeżeniem wymienionych wcześniej przypadków – prawie w tym przypadku naprawdę robi wielką różnicę), prawidłowo skonstruowane dane syntetyczne mogą się okazać skutecznym uzupełnieniem lub alternatywą dla danych rzeczywistych, które dzięki swoim właściwościom pozwolą nam tworzyć bardziej adekwatne, wiarygodne i skalowalne modele.
Kiedy warto sięgnąć po dane syntetyczne?
Choć te zalety uwidaczniają się w przypadku modelu każdego niemal typu, szczególnego znaczenia nabierają w przypadku modeli generatywnej sztucznej inteligencji (generative AI), która na własne potrzeby konsumuje olbrzymie ilości danych uczących. Znany dziś już chyba każdemu ChatGPT na pytanie czym jest generatywna sztuczna inteligencja, w 2023 roku udzielił następującej odpowiedzi: „Są to systemy sztucznej inteligencji typu black box, które wykorzystują techniki głębokiego uczenia na bardzo dużych zbiorach danych, aby tworzyć nowe treści tekstowe, wizualne i dźwiękowe na podstawie podpowiedzi lub istniejących danych”[1]. W tym kontekście truizmem wydaje się znane powiedzenie, że nie ma dobrej AI bez dobrej jakości danych. W szczególności danych, które sztuczna inteligencja może przetwarzać w sposób bezpieczny, gdyż, jak pokazują wyniki niektórych badań, nawet 75% decydentów jest zatroskanych o prywatność i bezpieczeństwo danych, które w ich organizacjach przetwarzane są przy wykorzystaniu generatywnej sztucznej inteligencji (z drugiej strony aż 80% z nich wykazało duże zainteresowanie wykorzystaniem danych syntetycznych do rozwiązywania problemów związanych z danymi i ich użyciem na potrzeby generatywnej sztucznej inteligencji – por. rysunek 2)[2].

Rysunek 2. Dane syntetyczne jako potencjalne remedium na problem bezpieczeństwa danych w systemach AI.
Dane syntetyczne – podobnie jak sama generatywna sztuczna inteligencja – zawierają więc w sobie potencjał, którego nie warto lekceważyć, na co w swych raportach wskazują najbardziej uznane branżowe organizacje analityczne i doradcze (por. rysunek 3). Co więcej, umożliwiają one wykorzystanie sztucznej inteligencji tam, gdzie niedostatek dobrej jakości (rzeczywistych) danych uczących sprawia, że zastosowanie technik generatywnej sztucznej inteligencji staje się zbyt ryzykowne z powodu zjawiska, które określa się słowem, jakie dotąd zarezerwowane było raczej dla zachowań przedstawicieli inteligencji naturalnej – zjawiska halucynacji – kiedy to system, z pełnym „przekonaniem” o prawdziwości udzielonej odpowiedzi (które to przekonanie może udzielić się również jej odbiorcy), konfabuluje. Odpowiednio wygenerowane dane syntetyczne mogą więc to ryzyko ograniczyć.

Rysunek 3. Wybrane opinie na temat rynkowego potencjału danych syntetycznych.
Rachunek zysków i strat
Niewątpliwe zalety wykorzystania danych syntetycznych w codziennej pracy analityka to jednak tylko jedna strona medalu – nie powinniśmy ignorować także ryzyka, jakie z korzystaniem z nich się wiąże, a decyzje o ich zastosowaniu podejmować po odpowiednim zważeniu zysków i strat. Na szczęście można chyba sformułować tezę, że główne ryzyko – jakość danych wynikowych i ich porównywalność do danych będących podstawą syntezy – da się w znacznym stopniu kontrolować, a wraz z doskonaleniem technik generowania danych syntetycznych także w coraz większym stopniu mitygować.
Wszystkim zainteresowanym technikami generowania danych syntetycznych polecam artykuł „Praktyczny przewodnik po generowaniu danych syntetycznych” link
[1] Black box AI systems that use deep learning on extremely large datasets to create new written, visual and auditory content given prompts or existing data.
[2] https://www.sas.com/en_us/offers/24q2/generative-ai-reports.html
Wyniki badania, przeprowadzonego przez SAS i Coleman Parkes Research wskazują, że 48 proc. polskich przedsiębiorstw wykorzystuje GenAI. To tylko nieco poniżej globalnej średniej, która wynosi 54 proc.
Deklarację wdrożenia tej technologii w ciągu najbliższych 2 lat złożyło zaś 46 proc. badanych firm. Pośród organizacji, które już dziś korzystają z AI, dalsze inwestycje w rozwiązania bazujące na algorytmach uczenia maszynowego w najbliższym roku fiskalnym planuje podjąć 89 proc. ankietowanych, z których aż 90 proc. ma już na to zabezpieczone środki w firmowych budżetach.
To silne zainteresowanie GenAI wskazuje na wysoki optymizm i pozytywne nastawienie do tego, w jaki sposób technologia ta może pomóc organizacjom i odzwierciedla podobne poglądy obserwowane na całym świecie. Można powiedzieć, że dawno żadna technologia nie była tak szybko adaptowana przez biznes, jak właśnie sztuczna inteligencja. Polskie firmy upatrują w GenAI korzyści w postaci podniesienia wydajności oraz oszczędności kosztów, a także pozytywnego wpływu na możliwości podejmowania decyzji w czasie rzeczywistym. Co ciekawe, oba te wskaźniki są znacznie wyższe niż średnia globalna. Na ten pierwszy aspekt w Polsce wskazało 74 proc. respondentów, przy średniej światowej na poziomie 49 proc., a na drugi – 64 proc., podczas gdy globalnie wskazuje go 37 proc. badanych.
W czym tkwi sekret popularności GenAI i jakie jej zastosowania są najbardziej powszechne?
Najistotniejszym bodźcem do podjęcia działań na rzecz wdrożenia AI są korzyści biznesowe. Szczególnie, że 100 proc. obecnych użytkowników tej technologii dostrzega poprawę wydajności przetwarzania dużych zbiorów danych, zmniejszenie kosztów operacyjnych, oszczędność czasu, a także korzyści w zakresie zarządzania ryzykiem i zgodnością. Więc pozytywna opinia na temat rozwiązań wykorzystujących GenAI niesie się w biznesie i każdy chce skorzystać z tej szansy.
Dziś w polskich firmach GenAI najczęściej wspiera działy marketingu – 47 proc. wskazań, obszar sprzedaży – 34 proc., oraz IT – 26 proc., czyli te sektory, w których występuje najwięcej powtarzalnych działań, które technologia ta z powodzeniem może przejąć, odciążając pracowników. Oczywiście w kolejce do wdrożeń już ustawiają się kolejne działy firm, takie jak R&D, produkcja czy finanse – jednak tu wykorzystanie sztucznej inteligencji dopiero jest w planach.
Jak wygląda adopcja tej technologii w innych krajach?
Zacięta walka o prymat toczy się obecnie pomiędzy Stanami Zjednoczonymi a Chinami, a za nimi na podium znalazły się organizacje z Wielkiej Brytanii. Obecnie w Państwie Środka z GenAI korzysta 83 proc. organizacji, podczas gdy na Wyspach brytyjskich 70 proc. firm, a w USA 65 proc. Jednak to najwięcej organizacji w USA może pochwalić się pełnym wdrożeniem GenAI i największą dojrzałością w jej wykorzystaniu – to aż 24 proc. badanych firm, podczas gdy w Chinach znajdziemy tylko 19 proc. takich organizacji, a w Wielkiej Brytanii – 11 proc. Przoduje sektor bankowy – 17 proc. organizacji tego typu globalnie może pochwalić się pełnym wdrożeniem GenAI, na drugim miejscu są firmy z obszaru telekomunikacji z wynikiem 15 proc., a na trzecim branża ubezpieczeniowa, której 11 proc. przedstawicieli w pełni wdrożyło GenAI w procesy biznesowe.
Jakie przeszkody napotykają firmy w zakresie wdrożenia i wykorzystania GenAI?
72 proc. polskich respondentów badania obawia się o zachowanie prywatności danych, 70 proc. – o ich bezpieczeństwo. 52 proc. ankietowanych jako wyzwanie wskazuje governance, czyli nadzór nad GenAI. Najpoważniejszym wyzwaniem związanym z implementacją GenAI jest przejście od fazy koncepcyjnej do praktycznej, na co w Polsce zwraca uwagę 64 proc. organizacji, podczas gdy średnia światowa jest o 17 punktów procentowych mniejsza. Kolejną kluczową przeszkodą jest efektywne wykorzystanie zbiorów danych. Wskazuje na nią 62 proc. polskich organizacji, na świecie zaś o 10 punktów procentowych mniej.
W skali globalnej, podstawowym wyzwaniem, z którym borykają się organizacje przy wprowadzaniu GenAI, jest brak jasnej strategii w zakresie jej wykorzystania. Zaledwie 9 proc. ankietowanych wskazuje, że są bardzo dobrze zaznajomieni z procesem wdrażania GenAI w swojej organizacji. A jedynie ¼ respondentów, których organizacje w pełni wdrożyły tę technologię stwierdziło, że są zaznajomieni ze strategią jej wdrażania. Ponadto dziewięć na dziesięć osób decyzyjnych w zakresie technologii przyznaje, że nie rozumie w pełni GenAI i jej potencjału w zakresie wpływu na procesy biznesowe.
Jak prezentują się polskie firmy na tle globalnym?
Polskie firmy są otwarte na innowacje i wdrażanie najnowszych rozwiązań GenAI. Wśród wszystkich badanych krajów Polska zajmuje 10. miejsce pod względem wykorzystania GenAI w biznesie, wyprzedzając takie kraje jak Kanada, Brazylia, Włochy, Belgia, Holandia i kraje skandynawskie. Jednak, podobnie jak w innych regionach, największym wyzwaniem pozostaje kwestia przygotowania do wdrożenia skutecznego zarządzania i monitorowania tej technologii. GenAI ma potencjał, aby znacząco zmienić wiele branż. Firmy muszą jednak upewnić się, że rozwiązania wykorzystujące generatywną sztuczną inteligencję są przejrzyste i oparte na ustalonych zasadach, a decyzje podejmowane przez algorytmy można wyjaśnić. Kluczowe jest korzystanie ze sprawdzonych i bezpiecznych narzędzi, które nie tylko gwarantują ochronę i prywatność danych, ale także zapewniają, że sztuczna inteligencja działa etycznie i uwzględnia aspekt odpowiedzialności organizacji za wykonywane działania.
Raport: Generatywna AI: Strategie Budowania Przewagi Konkurencyjnej można pobrać na stronie SAS https://www.sas.com/gms/redirect.jsp?detail=PLN37318_1794982053
– To, co robi algorytm, musi przynosić wymierne korzyści biznesowe, a AI governance to m.in. nadzór nad tym, jak AI wykorzystuje dane i podejmuje decyzje – mówi Marcin Hadyś, Head of Sales w SAS Polska.
Marcin Hadyś od początku swojej kariery zawodowej był związany z sektorem finansowym, pracując zarówno w firmach konsultingowych, jak i po stronie biznesu. Obecnie nadzoruje sprzedaż rozwiązań SAS w Polsce, skupiając się na generowaniu wartości biznesowej dla klientów.
Dopiero co przeciętny przedsiębiorca zapoznał się z terminem data governance i pojął jego znaczenie, pojawił się nowy termin – AI governance. Co to takiego?
Marcin Hadyś: Otrzymujemy takie pytania od klientów. Mówią nam często, że przecież ich organizacje są już data driven, mają wdrożone data governance albo data strategy, więc po co im coś więcej. Tymczasem o ile AI governance ma części wspólne z data governance, o tyle zakresy znaczeniowe tych pojęć i ich obszary nie pokrywają się. Bo jeśli w przypadku data governance koncentrujemy się na danych, ich źródłach, pochodzeniu, kompletności, jakości itd. – bo bez danych i ich odpowiedniego przygotowania w ogóle nie może być mowy o AI w organizacji – to zagadnienie AI governance jest bardziej wielowymiarowe. Dotyczy ono np. tego, czy w ogóle chcemy część decyzji – których podejmowanie może być zautomatyzowane, bo jest powtarzalne – scedować na tzw. maszynę, a jeśli tak, to jakie to mają być decyzje. Jeśli chcemy wykorzystać w ten sposób AI, powinniśmy wiedzieć, w oparciu o co nasz algorytm podejmuje te decyzje i dlaczego wyniki są takie, a nie inne. Idąc dalej trzeba także wskazać, kto z pracowników ostatecznie ponosi odpowiedzialność za decyzje podejmowane przez sztuczną inteligencję. Ponadto to, co robi algorytm, musi przynosić wymierne korzyści biznesowe, a AI governance to m.in. nadzór nad tym, jak AI wykorzystuje dane i podejmuje decyzje, co zapewnia, że jej działania są zgodne z oczekiwaniami i wartościami firmy.
Jakie zatem wymieniłbyś kluczowe zasady efektywnego i odpowiedzialnego zarządzania AI?
Myślę, że kluczową zasadą jest tu skoncentrowanie się na celu biznesowym podejmowanych działań. W SAS bardzo mocno skupiamy się właśnie na kontekście biznesowym tego, co proponujemy klientom. Nie chodzi przecież o analizowanie danych dla samego analizowania, ale o to, by przynieść firmie wymierną wartość, wymierną korzyść. To jest podstawa, którą zdarza się organizacjom „gubić” w tej całej modzie na AI. Aby sztuczna inteligencja przyniosła korzyści, musi działać w oparciu o zasady, założenia, dzięki którym da się zweryfikować, czy efekty jej działania są zgodne z oczekiwaniami. I to jest właśnie AI governance. To zapewnia transparentność podejmowanych decyzji. Oczywiście odpowiadam na to pytanie w ogromnym skrócie i uproszczeniu, bo należy tu uwzględnić wiele innych obszarów, w tym często omijane budowanie kultury organizacyjnej, wspierającej wykorzystanie AI.
Jakie są najczęstsze wyzwania, z którymi spotykają się firmy w zakresie AI governance i jak SAS pomaga je przezwyciężyć?
Sztuczna inteligencja sama w sobie jest wyzwaniem. Nie ma bowiem jednego rozwiązania, które przyniosłoby prostą odpowiedź, „ile AI” potrzebuje dana organizacja. To jest zawsze kwestia do zdefiniowania przez każdą firmę. I dlatego naszym klientom przypominamy zarówno o tym, że to od nich zależy, które zadania zamierzają powierzyć AI, jak i to, że za każdą decyzją, którą podejmuje maszyna, musi stać człowiek. To on musi brać pod uwagę, czy warunki zewnętrzne, w ramach których algorytm podejmuje decyzje, nie uległy zmianie. To bardzo ważny obszar AI governance. Chodzi tu nie tylko o samo wdrożenie rozwiązania, ale także o jego utrzymanie i monitorowanie, czyli zapewnienie zgodności z rzeczywistością, która zmienia się w czasie. Tu trzeba stale trzymać rękę na pulsie, bo od tego zależy skuteczność decyzji biznesowych, podejmowanych przez firmę.
Wyzwaniem dla wielu branż, np. bankowości, finansów czy ubezpieczeń, jest wytłumaczalność decyzji, które podjęła sztuczna inteligencja. Tu przechodzimy na trochę inny poziom rozmowy, bo znów różne branże i różne firmy będą potrzebować różnego poziomu tejże wytłumaczalności. W świecie finansów akurat ten aspekt jest niezwykle ważny, by zminimalizować ryzyko niewłaściwych decyzji i spełnić wymagania regulacyjne oraz ograniczyć dyskryminowanie określonych osób czy cech, jeśli akurat one mogą wpływać na podejmowaną przez instytucję finansową decyzję (np. udzielenie lub nie kredytu). W DNA naszych rozwiązań zapewniona jest ta wytłumaczalność – nigdy nie oferujemy firmom tzw. black boxa, który wypluwa wyniki bez możliwości nadzoru nad tym, co się dzieje w całym procesie.
Podczas naszych rozmów z klientami, wobec swoistego hype’u na GenAI, często musimy także tłumaczyć, że nie chodzi o to, by w organizacji tworzyć jakieś nowe procesy biznesowe, które wykonywać będzie sztuczna inteligencja. Skuteczne wykorzystanie AI to jej implementacja w tych procesach, które już mają miejsce w firmie. Takie pragmatyczne podejście często też jest wyzwaniem. Organizacje muszą iść dziś w stronę poszukiwania tych obszarów, w których AI może udoskonalić obecne procesy, co pozwoli osadzić narzędzia AI w biznesowym kontekście.
Czyli AI ma być dopełnieniem do tego, co dzieje się w firmie?
Dopełnieniem, uzupełnieniem, a następnie rozwinięciem. Pojmuję AI jako technologię wspierającą podejmowanie decyzji biznesowych, a generatywną sztuczną inteligencję jako dodatek do tradycyjnych rozwiązań AI w biznesie. To się wszystko musi łączyć. Wspólnym mianownikiem wszystkich zastosowań sztucznej inteligencji powinna być potrzeba biznesowa. Nie ma sensu szukanie use case’ów na siłę tylko po to, by pochwalić się wdrożeniem.
Jakie są różnice między różnymi dostawcami technologii AI i na co zwracać uwagę przy wyborze odpowiedniego partnera technologicznego?
MH: Myślę, że przede wszystkim trzeba tu zwrócić uwagę na to, że na rynku funkcjonują zarówno rozwiązania open source, jak i rozwiązania komercyjne. Te pierwsze wydają się bardziej atrakcyjne, gdyż przez wiele osób postrzegane są jako coś dostępnego „za darmo”. W końcu można je samemu dostosowywać do swoich biznesowych potrzeb. To prawda, tylko trzeba mieć umiejętność kodowania. Może to być właściwym podejściu dla niewielkich organizacji i procesów biznesowych w ograniczonym zakresie wspieranych analityką. Żeby to się powiodło w skali dużej firmy, to umiejętność taką posiadać musi wiele osób – programiści są wtedy potrzebni w każdej komórce albo niezbędny jest hub zrzeszający programistów w ramach całego przedsiębiorstwa. To rodzi zaś wyzwania w postaci kosztów, z których nie wszyscy zdają sobie sprawę, oraz w postaci konieczności przyciągnięcia ludzi z odpowiednimi umiejętnościami. Trzeba mieć to na uwadze, decydując się na tego typu inwestycję i przemyśleć, czy nie lepiej zdecydować się na rozwiązanie, które można dostosować do swoich potrzeb biznesowych nawet wtedy, gdy się nie jest programistą. Tak działa np. SAS Viya, czyli nasza platforma AI, która stanowi odpowiedź zarówno na potrzeby osób potrafiących kodować, jak i tych, które takich umiejętności nie posiadają.
Ponadto ważne jest, aby wybrać dostawcę, który oferuje nie tylko technologię, ale także wsparcie w jej efektywnym wdrażaniu i zarządzaniu nią. Tak właśnie działamy w SAS. Z jednej strony wiemy, co może dziś zaoferować technologia, z drugiej, dzięki bogatemu doświadczeniu w działaniach z biznesem rozumiemy, czego potrzebują firmy. Jesteśmy wiec niejako naturalnie podmiotem, który oba te obszary jest w stanie połączyć i pomóc firmom w osiągnięciu korzyści biznesowej, którą ma przynieść AI.
Czy możesz wskazać takie branże, w których dziś bez AI trudno jest funkcjonować?
Pierwsza, która przychodzi mi na myśl, to branża ubezpieczeniowa. Dziś funkcjonowanie w tym sektorze bez rozwiązania antyfraudowego, wspieranego właśnie analityką i AI, jest niemożliwe. Bo sytuacja, w której firma nie skorzysta z tego typu zabezpieczeń, nie oznacza tylko zwiększonego ryzyka. Oszuści bardzo szybko odkryją brak takich rozwiązań, co spowoduje, że ubezpieczyciel zacznie w mgnieniu oka przyciągać ich do swojej oferty. W efekcie będzie po prostu tracić kapitał i zakończy działalność na skutek braku płynności finansowej. Poza ubezpieczeniami można wspomnieć oczywiście bankowość, telekomunikację, ale także w coraz większym zakresie sektor usług publicznych.
Wyniki badania przeprowadzonego przez Coleman Parkes Research na zlecenie SAS pokazują, że 48% przedsiębiorstw w Polsce wykorzystuje generatywną sztuczną inteligencję, a 46% planuje to zrobić w ciągu najbliższych dwóch lat. Na czele tego zestawienia znalazły się Chiny, gdzie 83% firm zadeklarowało, że korzysta z GenAI, następnie Wielka Brytania – 70% i USA 65%. Jak oceniasz potencjał generatywnej sztucznej inteligencji? Czy zmieni ona sposób funkcjonowania branż w najbliższym czasie?
Tu wszystko zależy od naszego zrozumienia GenAI i umiejętności jej wykorzystania. Jeśli myśląc o tej technologii poprzestaniemy np. na ChatGPT – który jest jedną z dostępnych technologii – i wykorzystaniu go do tworzenia slajdów, pisania maili czy streszczania artykułów, to wejdziemy w ślepą uliczkę. Dlatego musimy sobie uświadomić, że GenAI jest technologią, która bardzo skutecznie usprawnia procesy biznesowe, i nauczyć się ją wykorzystywać. W SAS modele językowe wykorzystujemy np. do tego, by osoba, która nie ma kompetencji programisty, a nawet nie bardzo ma wiedzę o dostępnych danych, mogła przedstawić swoją potrzebę w języku naturalnym, a jej zapytanie było zrozumiane przez AI tak samo, jak kogoś innego, kto innymi słowami opisuje ten sam problem. To tylko jeden drobny przykład wykorzystania GenAI. Po swoistym „hype na GenAI” przyszedł już czas na zastanowienie się, jakie realne korzyści biznesowe może przynieść ta technologia. A jest tego bardzo dużo, przy czym trzeba także pamiętać o ryzykach, które niesie za sobą wdrożenie GenAI bez nadzoru.
Na koniec chciałem zapytać, jak oceniasz stopień adopcji AI i GenAI na polskim rynku? Które obszary lub branże się wyróżniają, a które zostają w tyle?
Wszystko zależy od punktu widzenia. Oczywiście w tym względnie przodują rynki azjatyckie. Niemniej Polska jest bardzo wysoko w tym zestawieniu. A jeśli chodzi o adopcję AI w takich sektorach, jak bankowość i ubezpieczenia, to uważam, że jesteśmy w awangardzie. Za to mam wrażenie, że sektor publiczny mógłby zwiększyć zakres zastosowań sztucznej inteligencji. Widzimy duży potencjał w tym obszarze, który jeszcze nie jest w pełni wykorzystany.
– AI po prostu pozwala robić różne rzeczy szybciej, bardziej wydajnie, i to jest sedno jej funkcjonowania – mówi Piotr Kaczyński, Senior Business Solutions Manager, SAS Global Technology Practice.
Piotr Kaczyński jest odpowiedzialny za rozwój biznesu w obszarze analityki i integracji systemów, również na styku rozwiązań SAS i narzędzi typu open source. Przez 8 lat prowadził badania nad zbieżnością algorytmów linearyzacji procesów stochastycznych. Od 2003 roku związany z obszarem analityki w zakresie praktycznego wykorzystania modelowania predykcyjnego do prognozowania w sektorze energetycznym. Brał również udział w projektach z zakresu eksploracji danych, BI i prognozowania dla transportu morskiego. Jego głównym zainteresowaniem jest AI i operacjonalizacja analityki w środowiskach produkcyjnych z wykorzystaniem metodologii ModelOps.
Wszyscy dziś mówią sztucznej inteligencji. Czy AI jest zagrożeniem dla ludzkości, czy wręcz przeciwnie – jest niebywałą szansą na rozwiązanie wielu problemów i bolączek? Jaka jest Twoja opinia na ten temat?
Dla mnie sztuczna inteligencja nie jest ani jednym, ani drugim. Tak naprawdę sztuczna inteligencja pojawiła się dawno temu. Przecież już w latach 50. ubiegłego wieku opracowany został koncept perceptronu. Czyli taki sposób obliczeń, który dziś nazywamy AI, był już stosowany od dawna. Udowodniono (choć trochę później), że takie funkcje, będące de facto składowymi modeli analitycznych, pozwalają rozwiązywać różne problemy aproksymacji i klasyfikacji, czyli rozdzielania hiperprzestrzeni na odpowiednie podprzestrzenie. I w zasadzie jedynym, co się zmieniło przez wszystkie te lata i co sprawia, że mamy możliwość stosowania tych algorytmów na co dzień, jest dostępność ogromnej mocy obliczeniowej. Każdy dziś może samemu „wyklikać” klaster z złożony z 10, 20 czy 50 komputerów (oczywiście ponosząc odpowiedni koszt). Natomiast ja upatruję w sztucznej inteligencji ułatwienia realizacji tych najbardziej żmudnych, wymagających ręcznej pracy, czynności. AI po prostu pozwala robić różne rzeczy szybciej, bardziej wydajnie, i to jest sedno jej funkcjonowania.
Kiedyś proces przygotowania obrazu zajmował kilka dni. AI skróciło go do godzin, a nawet minut. Ponadto AI wzbogaciła wielu z nas o kompetencje, których dotąd nie mieliśmy, jak właśnie możliwość tworzenia grafiki, muzyki, filmów. To oczywiście niesie też zagrożenia i możliwość nadużyć. Ostatnio w ramach jednej z prelekcji pokazałem film wygenerowany przez AI, w którym to prezes naszej firmy obiecywał wszystkim uczestnikom spotkania po 10 tys. dolarów premii za udział w wydarzeniu. Wygenerowanie tego filmu zajęło mi około 5 minut, a sztucznej inteligencji wystarczyło 30 sekund głosu prezesa, żeby wygenerować i włożyć w jego usta w zasadzie dowolny tekst. Oczywiście to może niepokoić, ale jednocześnie pokazuje, jak AI ułatwia wiele działań, jak usprawnia i przyspiesza ludzką pracę.
Kto zatem współcześnie odpowiada za tę zmianę, za ten szybki rozwój AI? Kto ją dziś napędza? Analitycy, biznes, operatorzy centrów danych, społeczeństwo, może sama AI?
Myślę, że ten rozwój dziś po trosze napędza każda z wymienionych grup. Z jednej strony warto popatrzeć na to, kto na tym zarabia. Tu pierwszymi beneficjentami będą operatorzy centrów danych, którzy dostarczają mocy obliczeniowej. Ale równorzędnym beneficjentem z pewnością jest biznes.
Natomiast jeśli popatrzymy na opracowania pokazujące, gdzie stosowana jest generatywna AI, to okaże się, że najczęściej wykorzystują ją działy IT. Pewne działania dla specjalistów IT są po prostu żmudne, a że wiedzą oni, jak je usprawnić, to sami sobie wymyślają narzędzia. Tym bardziej, że usprawnienia dotyczą kwestii powtarzalnych, automatycznych, które nie wymagają angażowania inteligencji „białkowej”, jak w przypadku generowania obrazów.
Na które zastosowania AI powinien zwrócić uwagę biznes?
Na pewno warto przyjrzeć się takim zastosowaniom generatywnej AI, w których, jak sama nazwa wskazuje, coś generujemy, czyli tworzymy dużo tekstu, wiele obrazów i do tego te czynności są powtarzalne. Oczywiście modele fundamentalne można stosować też w przypadku różnych klasyfikacji, ale przykłady pokazują, że tutaj zauważalne są pewne niedociągnięcia i niedokładności. Więc prawdziwą wartość AI na pewno możemy zbudować, jeżeli będziemy ją wykorzystywać do realizacji tych zadań, które wymagają generowania dużej ilości tekstu, kodu, który jest powtarzalny i który można w łatwy sposób zweryfikować. Jednak powinniśmy zakładać możliwość interwencji człowieka w tym procesie, aby mieć pewność, że wygenerowane wyniki są prawidłowe. Dużo prościej jest przeczytać maila i poprawić go, niż pisać od początku całą wiadomość. Dużo prościej jest przeczytać przygotowane przez AI streszczenie wątku np. złożonej przez klienta reklamacji. Gdy operator musi przeczytać całą historię konwersacji, to łatwiej mu będzie po prostu przeczytać streszczenie przygotowane przez generatywną AI. Z drugiej strony pisząc odpowiedź też pewnie dobrze by było, aby taki konsultant miał wygenerowaną sugestię odpowiedzi i tylko ją zweryfikował. To na pewno przyspiesza pracę i pozwala oszczędzić czas. Poza tym, zwiększa to satysfakcję z pracy osobom, które zajmują się tego typu powtarzalnymi działaniami.
Które branże najchętniej wdrażają modele generatywnej sztucznej inteligencji?
Jeżeli mówimy o generatywnej sztucznej inteligencji, to obecnie jest na nią taki hype, że wszystkie branże zaczynają eksperymentować. Natomiast, z mojego doświadczenia wynika, że pierwsze zauroczenie GenAI minęło. Osoby, które faktycznie implementują takie rozwiązania oparte o modele językowe zauważają problemy z ich stosowaniem, dostrzegają ich nieprzewidywalność i „niewyjaśnialność”, czyli trudność w wytłumaczeniu wyników wygenerowanych przez tego typu model. Okazuje się na przykład, że bardzo istotne jest to, w jaki sposób zadamy pytanie algorytmowi. Oczywiście możemy pokazać świetne przykłady, gdzie sztuczna inteligencja doskonale rozwiązuje pewne zadania. Ale gdy rozmawiam z różnymi osobami z firm, z którymi współpracujemy, to pokazują mi oni konkretne przykłady niezrozumiałych działań algorytmów. Na przykład, gdy w zapytaniu skasują jedną spację, to odpowiedź udzielona przez model będzie zupełnie inna, niż kiedy ta spacja w zapytaniu się znajdzie.
Z jednej strony ogólnie wiemy, jak te algorytmy działają, ale z drugiej strony nie umiemy przewidzieć tego, w jaki sposób się zachowają w danej sytuacji. Stąd mam sceptyczną opinię na temat tego, że generatywna sztuczna inteligencja zupełnie zawojuje biznes i zastąpi człowieka. Raczej powinniśmy myśleć o jej wykorzystaniu do działań powtarzalnych, jak generowanie tekstu, który następnie będzie weryfikowany przez pracownika. Na to też wskazuje moje doświadczenie. Implementujemy narzędzia AI w contact center, call center, centrach obsługi klienta i takich departamentach, które muszą po prostu generować dużo odpowiedzi, dużo maili. Co ciekawe, tutaj często też wykorzystujemy modele deep czy machine learningowe, czyli jakby tę sztuczną inteligencję w wersji 1.0, jeśli generatywną AI określimy sobie jako wersję 2.0. Wykorzystujemy te modele do tego, żeby w odpowiedni sposób skonstruować właśnie zapytanie do GenAI.
Bardzo ciekawym zastosowaniem generatywnej AI jest też wykorzystanie jej do interakcji z bardzo skomplikowanymi algorytmami optymalizacji. Optymalizacja to jest stricte matematyka. Tutaj nie dzieje się jakaś wielka magia, nie ma neuronów, warstw, sieci neuronowych i tych wszystkich pięknych pojęć. Tu wszystko opiera się na matematyce, która przynosi konkretną wartość biznesową, bo albo zwiększamy zyski, albo minimalizujemy koszty. Wyobraźmy sobie, że chcemy np. zoptymalizować zużycie wody przy produkcji papieru. Mamy więc pewne parametry wejściowe do tego algorytmu optymalizacji. Jednak sama parametryzacja, sama interakcja z tym algorytmem i zmiana parametrów, a potem uruchomienie optymalizacji, może być trudne. Więc generatywną AI możemy zastosować do tego, żeby w języku naturalnym powiedzieć: „A co by było, gdybyśmy zmienili to i to? Gdybyśmy mieli mniejszy zasób wody? Nie 500 litrów, jak dotychczas, tylko 400?”. I wtedy generatywna AI może uruchomić zagadnienie optymalizacji i odpowiedzieć pewnym wynikiem, który będzie zrozumiały także dla laika. To przykład, że GenAI może być interfejsem do bardziej skomplikowanej maszynerii, która leży pod spodem, a my komunikujemy się z nią za pomocą słów, czyli języka naturalnego.
Oczywiście każde zastosowanie AI w biznesie musi się opłacać. Pamiętajmy, że przecież każde takie rozwiązanie w skali dużej organizacji generuje wymierne koszty, choćby zużywając energię elektryczną. Dlatego w każdym przypadku decyzję o wdrożeniu AI trzeba dobrze przemyśleć. I na pewno warto także skonsultować się ze specjalistami, którzy robią to na co dzień. Choćby po to, żeby usłyszeć ich podpowiedzi, w których obszarach AI może w danym biznesie usprawnić działania.
Jak widzisz rozwój technologii generatywnej AI np. w ciągu 5 najbliższych lat?
Myślę, że przede wszystkim zwiększy się skala jej zastosowań. Raczej nie jestem w stanie sobie wyobrazić żadnego przełomu, nowego odkrycia czy rozwiązania, które miałoby się pojawić – doświadczymy po prostu efektu skali. Do tego będziemy mieli do czynienia z bardziej precyzyjnymi algorytmami. Takimi, które będą mniej halucynować. Z drugiej stronny będziemy umieli bardziej kontrolować i weryfikować czy monitorować to, co otrzymujemy od różnych modeli generatywnej sztucznej inteligencji. Zapewne w tym też obszarze będzie największy rozwój. Natomiast w przyszłości pewnie znajdziemy takie metody, które będą pozwalały nam mieć większą pewność, że to, co zostało wygenerowane przez AI, jest prawidłowe. Niemniej generatywna sztuczna inteligencja sama w sobie jest przełomem, bo jest technologią transformacyjną. Do takich technologii zaliczyłbym te, które zmieniają świat globalnie, stając się dostępnymi dla każdego, jak koło, pismo, maszyny parowe, elektryczność, internet. To jest z pewnością technologia tej rangi.
Mówisz tutaj o szansach i o pewnych nadziejach. Widzisz może też jakieś zagrożenia w tym wszystkim?
Największym zagrożeniem według mnie jest brak chęci zrozumienia czy pogłębienia wiedzy o świecie i o generatywnej AI ze strony człowieka. Ludzie nie chcą się uczyć, przyjmują pewne rzeczy „z dobrodziejstwem inwentarza”, takimi, jakie je widzą. Oczywiście jest to wynik naturalnej cechy ludzkiego umysłu do pewnego generalizowania. Bo skąd się biorą fejki? Dlaczego są zagrożeniem? Dlatego, że nikt nie zadaje sobie pytania czy, odwołując się do użytego już wcześniej przykładu, prezes dużej firmy może każdemu uczestnikowi konferencji dać 10 tysięcy dolarów. Trzeba cały czas wątpić i zaszczepiać w ludziach gen pozytywnie krytycznego podejścia do tego, co widzą i słyszą.
Czyli znowu wracamy do ludzi, którzy są tutaj najsłabszym ogniwem, a jednocześnie czynnikiem krytycznym. A skoro o ludziach mowa, to warto dziś jeszcze studiować analitykę danych lub informatykę?
Zarówno z wykształcenia, jak i z zamiłowania jestem matematykiem. Jestem przekonany, że kompetencje matematyczno-logiczne zawsze będą cenne. Uważam, że trzeba się uczyć takich rzeczy, które są uniwersalne i w pewien sposób potem będą procentować i zbudują nasze kompetencje. Dlatego na pytanie: „Którego języka programowania dziś się uczyć?” odpowiadam „Nie wiem”. Bo nie tu znajduje się sedno zagadnienia.
Zacytowałbym tutaj mojego idola, czyli największego polskiego matematyka Stefana Banacha. On powtarzał, że: „Dobrym matematykiem jest ten, kto umie znajdować analogie między twierdzeniami; lepszym matematykiem – kto widzi analogie pomiędzy teoriami, a genialnym ten, kto dostrzega analogie między analogiami.” To właśnie możliwość generalizacji, uogólniania i wyprowadzania z tego nowych odkryć, znajdowanie nowych zastosowań jest najistotniejsze.
Jak widać, wszystko tu jest kwestią podejścia, kiedy zaczynamy działać od podstaw i krok za krokiem odkrywamy mechanizmy, schematy, analogie. Natomiast kluczowe jest zrozumienie tego, w jaki sposób coś działa i jakie są tego podstawy. To jest dla mnie sedno studiowania czy generalnie uczenia się i zdobywania wiedzy.
Na koniec zostawiłem jeszcze jedno pytanie. „Feature Store Manager usprawnia przepływ pracy dla projektów związanych ze sztuczną inteligencją i uczeniem maszynowym, znacznie skracając czas potrzebny na wprowadzenie nowych produktów AI na rynek” – czytam w poście na LinkedIn dr. Dwijendra Dwivedi, szefa zespołu ds. AI i IoT w SAS, w którym chwali się, że rozwiązanie to uzyskało ochronę patentową w USA. W poście jesteś wymieniony jako członek zespołu, który realizował ten projekt. Czy mógłbyś opowiedzieć więcej o tym rozwiązaniu?
Tym, co zostało opatentowane, jest tak naprawdę unowocześnienie konceptu, który nazywa się Feature Store, czyli magazyn cech. W projekcie tym nie koncentrowaliśmy się na szeroko rozumianej sztucznej inteligencji czy algorytmach machine learningowych, które służą do tworzenia modeli AI lub ich implementacji. Projekt ten skupiał się na tym, co jest szarą rzeczywistością data scientistów, czyli na kwestii przygotowania danych do tworzenia modeli AI. Zależało nam na tym, aby te dane można było przygotowywać szybciej i prościej, a przede wszystkim w sposób umożliwiający ich ponowne użycie.
Badania różnych globalnych firm doradczych pokazują, że etap opracowania i wyczyszczenia danych w całym cyklu przygotowania analitycznego zabiera najwięcej czasu osobom, które tworzą modele analityczne i je wdrażają. Z drugiej strony to, co dzieje się na tym etapie, w istotny sposób wpływa później na jakość modeli. Zgodnie z zasadą „rubbish in – rubbish out”, jeśli działamy na dobrych, dobrze przygotowanych danych, to i opracowane później na ich podstawie modele są lepsze.
Skoncentrowaliśmy się więc na tym właśnie procesie i stworzyliśmy rozwiązanie, którego biznesowa wartość polega na tym, że pozwala ono data scientistom na wygenerowanie odpowiednich zbiorów danych w sposób zautomatyzowany, przy wykorzystaniu innowacyjnego sposobu naliczania nowych zmiennych. Mówiąc w skrócie: dzięki naszemu rozwiązaniu nowe modele AI mogą być szybciej wdrażane produkcyjnie i można je szybciej aktualizować o nowe dane.